Domain integralesleben.de kaufen?
Wir ziehen mit dem Projekt
integralesleben.de um.
Sind Sie am Kauf der Domain
integralesleben.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain integralesleben.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **


Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
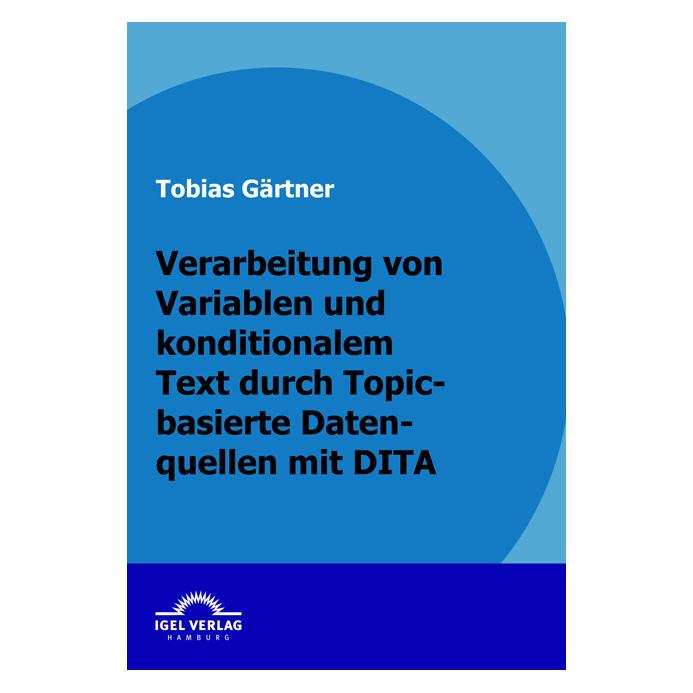
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Handbuch Historische AuthentizitätHandbuch Historische Authentizität , Von »Digitalität« bis »Heimat«, von »Fake« bis »Industriekultur« - ein außergewöhnliches Handbuch. Authentizität stellt einen Schlüsselbegriff der Geschichts- und Erinnerungskultur am Übergang zum 21. Jahrhundert dar. Das interdisziplinäre Handbuch "Historische Authentizität" erschließt die Vielgestalt des Begriffs und seiner Verwendungsweisen in unterschiedlichen wissenschaftlichen, musealen und geschichtskulturellen Kontexten. Konzipiert als ein semantisches Netz, sucht das Handbuch die Problematik und Wirkungsmacht ebenso wie die Faszinationskraft historischer Authentizität zu erklären. Mit ca. 70 Beiträgen, u.a. über "Autorschaft und Autorisierung" (Michael Wetzel), "Denkmalpflege" (Ingrid Scheurmann), "Digitalität" (Andreas Fickers), "Fake" (Martin Doll), "Fälschung" (Thomas Eser), "Geschichtsmarketing" (Manfred Grieger), "Heimat und Fremde" (Maren Möhring), "Industriekultur" (Michael Farrenkopf u. Torsten Meyer); "Karten" (Peter Haslinger) "Meisterwerk" (Heike Zech), "Museum" (Thomas Thiemeyer), "Patina" (Oliver Mack), Provenienzforschung (Ulrike Schmiegelt-Rietig), "Rekonstruktion" (Arnold Bartetzky), "Sakralisierung" (Johannes Paulmann); "Substitute" (Markus Walz), "Typus, Art und Gattng" (Willi Xylander) und "Zeitschichten" (Achim Landwehr). , Sonstige > Kraftstoffversorgung , Erscheinungsjahr: 20220810, Produktform: Leinen, Titel der Reihe: Wert der Vergangenheit##, Redaktion: Sabrow, Martin~Saupe, Achim, Seitenzahl/Blattzahl: 592, Abbildungen: mit 6 farb. Abbildungen, Themenüberschrift: HISTORY / Reference, Keyword: 21. Jahrhundert; Authentizität; Autorisierung; Autorschaft; Begriff; Denkmalpflege; Digitalität; Erinnerung; Erinnerungskultur; Fake; Fälschung; Geschichts; Geschichtskultur; Geschichtsmarketing; Geschichtswissenschaft; Heimat und Fremde; Kultur; Meisterwerk; Museum; Patina; Provenienzforschung; Rekonstruktion; Substitute; Verwendung; Wissenschaft; interdisziplinär, Fachschema: Authentizität~Geschichtswissenschaft, Fachkategorie: Gesellschaft und Kultur, allgemein~Geschichte allgemein und Weltgeschichte~Nachschlagewerke, Zeitraum: Ur- und Frühgeschichte~Vorzeit, Frühgeschichte vor Christi Geburt~Christi Geburt bis 1500 nach Chr.~1500 bis heute, Warengruppe: HC/Geschichte/Allgemeines/Lexika, Fachkategorie: Sozial- und Kulturgeschichte, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Wallstein Verlag GmbH, Verlag: Wallstein Verlag GmbH, Verlag: Wallstein-Verlag GmbH Verlag und Werbung, Länge: 246, Breite: 183, Höhe: 46, Gewicht: 1228, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 282082242,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Herausforderung im effizienten Umgang mit Daten unter Berücksichtigung von unterschiedlichen Datenquellen, Taschenbuch von Hans Schätzle, GRIN,Herausforderung Im Effizienten Umgang Mit Daten Unter Berücksichtigung Von Unterschiedlichen Datenquellen, Taschenbuch Von Hans Schätzle, Grin, 978-3-346-59698-7, Seitenanzahl: 3617,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Handbuch Historische AuthentizitätHandbuch Historische Authentizität , Von »Digitalität« bis »Heimat«, von »Fake« bis »Industriekultur« - ein außergewöhnliches Handbuch. Authentizität stellt einen Schlüsselbegriff der Geschichts- und Erinnerungskultur am Übergang zum 21. Jahrhundert dar. Das interdisziplinäre Handbuch "Historische Authentizität" erschließt die Vielgestalt des Begriffs und seiner Verwendungsweisen in unterschiedlichen wissenschaftlichen, musealen und geschichtskulturellen Kontexten. Konzipiert als ein semantisches Netz, sucht das Handbuch die Problematik und Wirkungsmacht ebenso wie die Faszinationskraft historischer Authentizität zu erklären. Mit ca. 70 Beiträgen, u.a. über "Autorschaft und Autorisierung" (Michael Wetzel), "Denkmalpflege" (Ingrid Scheurmann), "Digitalität" (Andreas Fickers), "Fake" (Martin Doll), "Fälschung" (Thomas Eser), "Geschichtsmarketing" (Manfred Grieger), "Heimat und Fremde" (Maren Möhring), "Industriekultur" (Michael Farrenkopf u. Torsten Meyer); "Karten" (Peter Haslinger) "Meisterwerk" (Heike Zech), "Museum" (Thomas Thiemeyer), "Patina" (Oliver Mack), Provenienzforschung (Ulrike Schmiegelt-Rietig), "Rekonstruktion" (Arnold Bartetzky), "Sakralisierung" (Johannes Paulmann); "Substitute" (Markus Walz), "Typus, Art und Gattng" (Willi Xylander) und "Zeitschichten" (Achim Landwehr). , Sonstige > Kraftstoffversorgung , Erscheinungsjahr: 20220810, Produktform: Leinen, Titel der Reihe: Wert der Vergangenheit##, Redaktion: Sabrow, Martin~Saupe, Achim, Seitenzahl/Blattzahl: 592, Abbildungen: mit 6 farb. Abbildungen, Themenüberschrift: HISTORY / Reference, Keyword: 21. Jahrhundert; Authentizität; Autorisierung; Autorschaft; Begriff; Denkmalpflege; Digitalität; Erinnerung; Erinnerungskultur; Fake; Fälschung; Geschichts; Geschichtskultur; Geschichtsmarketing; Geschichtswissenschaft; Heimat und Fremde; Kultur; Meisterwerk; Museum; Patina; Provenienzforschung; Rekonstruktion; Substitute; Verwendung; Wissenschaft; interdisziplinär, Fachschema: Authentizität~Geschichtswissenschaft, Fachkategorie: Gesellschaft und Kultur, allgemein~Geschichte allgemein und Weltgeschichte~Nachschlagewerke, Zeitraum: Ur- und Frühgeschichte~Vorzeit, Frühgeschichte vor Christi Geburt~Christi Geburt bis 1500 nach Chr.~1500 bis heute, Warengruppe: HC/Geschichte/Allgemeines/Lexika, Fachkategorie: Sozial- und Kulturgeschichte, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Wallstein Verlag GmbH, Verlag: Wallstein Verlag GmbH, Verlag: Wallstein-Verlag GmbH Verlag und Werbung, Länge: 246, Breite: 183, Höhe: 46, Gewicht: 1228, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 282082242,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
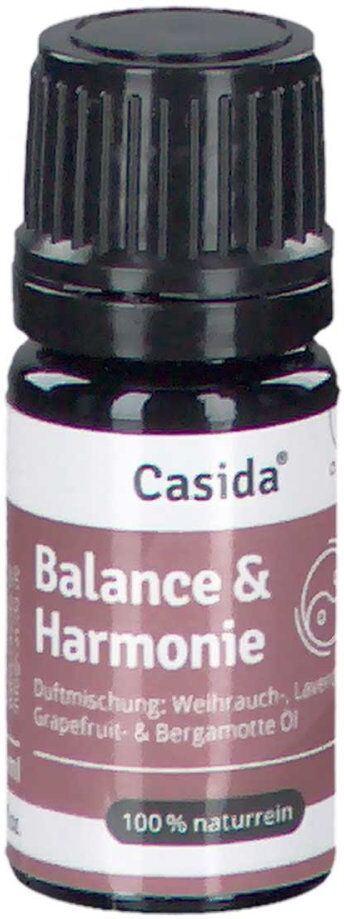
Casida Balance & Harmonie DuftmischungAnwendungsgebiet von Balance & Harmonie DuftmischungBalance & Harmonie Duftmischung ist eine Duftmischung mit ausgewogener, harmonischer Note. Der harzig-frische Duft von Weihrauch eröffnet mit einer warmen, würzigen Tiefe, die sich harmonisch mit dem sanft-blumigen Aroma des Lavendels verbindet. Spritzige Noten von Grapefruit und die belebende Frische der Bergamotte verleihen dem Ausklang eine lebendige, fruchtige Leichtigkeit – für ein ausgewogenes, vielschichtiges Dufterlebnis, das Körper und Geist gleichermaßen anspricht.Wirkstoffe / Inhaltsstoffe / ZutatenBalance & Harmonie Duftmischung enthält:Boswellia Carterii Oil, Lavandula Angustifolia (Lavender) Oil, Citrus Paradisi (Grapefruit) Peel Oil, Citrus Aurantium Bergamia (Bergamot) Peel Oil, Geraniol*, Citronellol*, Citral*, Limonene*, Linalool**= natürliche Bestandteile d. ätherischen ÖlsGegenanzeigenBei bekannter Überempfindlichkeit gegenüber einem der oben genannten Inhaltsstoffe sollte das Produkt nicht angewendet werden.DosierungAnwendungsempfehlung von Balance & Harmonie Duftmischung:Das Öl sollte stets verdünnt angewendet werden. Es ist nicht zur Einnahme geeignet und sollte nicht unverdünnt direkt auf die Haut aufgetragen werden. Für kosmetische Anwendungen wird empfohlen, es mit einem geeigneten Trägeröl zu mischen. Vor der großflächigen Anwendung empfiehlt sich ein Verträglichkeitstest auf einer kleinen Hautstelle. Vor Kindern geschützt aufbewahren.HinweiseUnsere ätherischen Öle sind vollkommen naturrein und enthalten keine synthetischen Zusätze. Kühl, lichtgeschützt und außerhalb der Reichweite von Kindern lagern. Balance & Harmonie Duftmischung können in Ihrer Versandapotheke www.juvalis.de erworben werden.9,36 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Balance & Harmonie Duftmischung 5 MLProdukteigenschaften: Duftmischung Balance & Harmonie Duftmischung mit ausgewogener, harmonischer Note. Beschreibung: Durch die kontrollierten Inhaltsstoffe ist die Duftmischung Balance & Harmonie absolut rein und natürlich. Die patentierte Violettglasflasche schützt das wertvolle ätherische Öl vor UV-Einwirkung. Ideal für die Aromatherapie und für Aromadiffuser geeignet. Die Duftmischung besticht durch eine harmonische Kombination aus sanften Blüten- und würzigen Holznoten. Selbstverständlich verzichten wir konsequent auf Tierversuche. Der Duft von harzig-frischem Weihrauch entfaltet zunächst eine warme, würzige Tiefe, die sich nahtlos mit dem sanft-blumigen Charakter des Lavendels verwebt, während spritzige Grapefruitakkorde und frisch-fruchtige Bergamotte einen lebhaften, facettenreichen Ausklang bilden, der für ein rundum ausgewogenes Dufterlebnis sorgt. Hinweise zur Anwendung: Das Öl sollte stets verdünnt angewendet werden. Es ist nicht zur Einnahme geeignet und sollte nicht unverdünnt direkt auf die Haut aufgetragen werden. Für kosmetische Anwendungen wird empfohlen, es mit einem geeigneten Trägeröl zu mischen. Testen Sie das Öl zuerst auf einer kleinen Hautstelle, um sicherzustellen, dass keine Reaktionen auftreten. Vor Kindern geschützt aufbewahren. Bei Unsicherheiten während Schwangerschaft oder Stillzeit bitte Rücksprache mit einer Fachperson halten. Raumduft: Mit nur 1 - 2 Tropfen pro 10 m2 Raumgröße erfüllt die Duftmischung den Raum mit einer harmonischen und blumigen Note. Körperpflege: Maximal 5 Tropfen mit 50 ml Trägeröl mischen und auf die Haut auftragen. Badezusatz: Maximal 10 Tropfen ins warme Badewasser geben. Ingredients: Boswellia Carterii Oil, Lavandula Angustifolia (Lavender) Oil, Citrus Paradisi (Grapefruit) Peel Oil, Citrus Aurantium Bergamia (Bergamot) Peel Oil, Geraniol*, Citronellol*, Citral*, Limonene*, Linalool*. *= natürliche Bestandteile d. ätherischen Öls Quelle: https://casida.com Stand: 08/20259,99 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.